Ein Kunde sucht eure Marke, klickt auf eine Sponsored-Products-Anzeige und kauft. Der Anzeigenreport schreibt den Verkauf der Kampagne zu. Ob der Kunde ohne Anzeige beim organischen Treffer ebenfalls gekauft hätte, steht dort nicht. Für große Marken mit bestehender Nachfrage kann diese Lücke über Millionenbudgets entscheiden.
Drei Größen gehören getrennt in den Bericht: zugerechneter Umsatz, neu für die Marke klassifizierte Käufer und zusätzliche Verkäufe gegenüber einem vergleichbaren Zustand ohne Werbung. Die dritte Aussage benötigt einen brauchbaren Gegenvergleich.
Was Standardreports leisten
| Kennzahl | Was sie tatsächlich beschreibt | Was sie offenlässt |
|---|---|---|
| ACoS/ROAS | Werbekosten und nach den Regeln zugerechnete Verkäufe | Hätte der Kunde auch ohne Anzeige gekauft? |
| New-to-Brand | Käuferhistorie innerhalb Amazons jeweiliger Definition | Hat die Anzeige den ersten Kauf verursacht? |
| AMC-Analyse | Verknüpfte, berechtigte Ereignisse und beobachtbare Pfade | Eine gute Segmentierung erzeugt keine Kontrollgruppe |
| Brand Lift | Befragungsbasierten Unterschied in Markenwahrnehmung | Zusätzlichen Produktabsatz in Euro |
Amazon Marketing Cloud kann helfen, Berührungspunkte und Zielgruppenüberschneidungen zu untersuchen. Wer nachträglich „Exponierte“ mit „Nicht exponierten“ vergleicht, vergleicht möglicherweise unterschiedliche Personen. Die bloße AMC-Nutzung macht eine Auswertung nicht kausal.
Eine beantwortbare Testfrage formulieren
Nehmt etwa eine Produktgruppe mit stabiler Lieferfähigkeit und fragt: Erzeugt eine zusätzliche, definierte Werbeschicht bei bislang nicht angesprochenen Kunden mehr Deckungsbeitrag, als Media und Durchführung kosten? Legt vor Start Produktliste, Testperiode, Kontrollverfahren, Zielkennzahl, maximale Kosten und erlaubte Änderungen fest.
Ein randomisierter Vergleich ist nur aussagekräftig, wenn die Gruppen tatsächlich vergleichbar sind, die Umsetzung funktioniert und die erwartete Wirkung groß genug für die Datenmenge ist. Nicht jeder Account hat Zugang zu jeder Testfunktion. Falls kein belastbarer Kontrollversuch verfügbar ist, bezeichnet das Ergebnis als Beobachtung, nicht als erwiesene Zusatzwirkung.
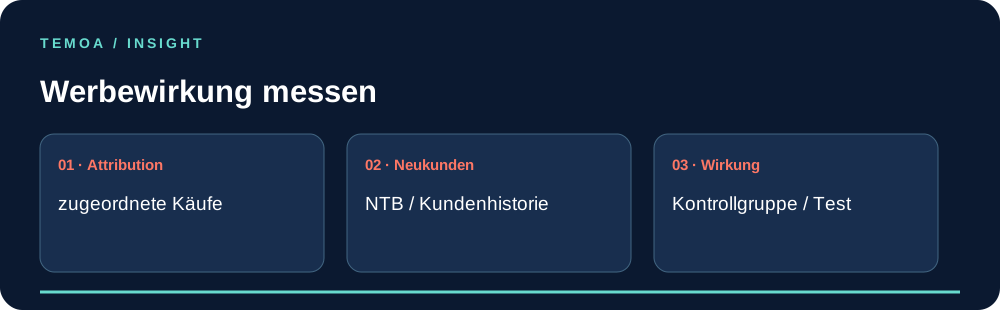
Diese Zahlen sollen nicht zeigen, dass eine kleine Kampagne statistisch ausreicht. Sie zeigen, welche wirtschaftliche Brücke euer Report schlagen muss. Der Effekt gehört mit Bandbreite, Durchführungsfehlern und weiteren Kosten präsentiert.
Wo ein Test scheitert, obwohl die Kampagne läuft
Kontamination: Dieselben Käufer erreichen das Produkt durch andere Anzeigen, Promotion oder ein Reseller-Angebot. Bestandsbruch: Die Test-ASIN wird während des Versuchs knapp, die Vergleichs-ASIN nicht. Auswahlfehler: Eine Gruppe enthält von Beginn an kaufbereitere Menschen. Zu wenig Daten: Der Test hat rechnerisch keine Chance, eine für euch relevante Wirkung sauber vom Rauschen zu trennen.
Protokolliert parallele Preis-, Bestands- und Contentänderungen. Legt das kleinste wirtschaftlich wichtige Ergebnis fest, bevor die erste Zahl sichtbar wird. Bei einem uneindeutigen Test investiert ihr in ein besseres Design oder eine kleinere Frage, statt eine gewünschte Interpretation aus der Kampagne zu lesen.
Die Konsequenz für den Budgetplan
Bei Branded Search kann Verteidigung sinnvoll sein; der zugerechnete ROAS überschätzt möglicherweise den zusätzlichen Effekt. Bei generischer Nachfrage kann ein niedrigerer Standard-ROAS akzeptabel sein, wenn der nachweisbare zusätzliche Beitrag höher ist. Weder die eine noch die andere Aussage ist ohne passende Prüfung garantiert.
Wir verbinden PPC-Planung mit Analytics & Reporting und einer klaren Entscheidung über die nächste Budgetstufe. Für DSP gelten dieselben Messfragen; die Budget- und Zugangsmodelle kommen hinzu. Sprecht mit uns, wenn ihr für eine konkrete Kampagne eine Zusatzwirkungsfrage formulieren wollt.
Quellen und Geltungsbereich
Amazon Ads: Marketing Cloud und Amazon Ads: Brand Lift. Geprüft am 17. Oktober 2026. Das Experiment und seine Rechnung sind illustrative Modelle, keine verfügbaren Standardfunktionen oder Kundenergebnisse.